Wykrywaj teksty generowane przez AI na Twoim własnym komputerze.
Linda ocenia, czy tekst zostal wygenerowany przez AI, i podswietla podejrzane fragmenty.
12 prób · maks. 6 000 znaków · minimum 20 słów, zalecane 300+. TXT, MD, DOCX. Demo online wysyła tekst na serwer; aplikacja na komputerze działa lokalnie.
Teksty i modele zostają na Twoim komputerze
Detekcja jest lokalna. Modele: około 0,3 GB dla Loupe lub 2,9 GB dla Assay; analiza może działać offline. Aktualizacje i aktywacja/okresowa kontrola licencji korzystają z sieci bez wysyłania tekstów.
Bezpłatnie do osobistego użytku niekomercyjnego. Klucz nie jest potrzebny — pobierz i sprawdzaj.
W Microsoft Store aktualizacje pojawiają się zwykle około tygodnia później niż na GitHubie. Potrzebujesz najnowszej wersji od razu? Pobierz instalator z GitHuba.
na CPU
81% z 1 675 tekstów AI przepisanych przez 16 narzędzi „humanizer” nadal jest rozpoznawanych jako AI (publiczny zbiór HumanizerBench, nieużyty do treningu). Szczegóły w Wynikach
Linda Assay i Linda Loupe
Wybierz to, co pasuje do Twojego komputera. Można zainstalować jedną lub obie, a później zmienić to w ustawieniach.
Aktualne wersje: aplikacja 2.0.7.0 · pakiet modeli 1.3.4.1. Assay FP32 stable / Loupe CPU; krótkie wstawki AI mogą pozostać niewykryte.
Linda Loupe
Lekka i szybka. Działa na każdym komputerze, nawet na starym laptopie bez gamingowej karty graficznej.
- Sprawdzanie trwa sekundy
- Małe pobieranie (około 0,3 GB)
- Nieco mniej dokładna
Linda Assay
Najdokładniejsza wersja. Najlepsza z nowoczesną kartą graficzną.
- Najwyższa dokładność
- Pobieranie około 3 GB
- Na słabym komputerze długi tekst może trwać minuty
Nie jesteś pewien?
Zacznij od Linda Loupe: działa wszędzie. Gdy zechcesz maksymalnej dokładności, dodasz Linda Assay w ustawieniach jednym kliknięciem.
co wykrywa Linda Assay i jak często się myli
zwykłych tekstów AI wykrytych
na publicznym benchmarku Chicago Booth (teksty GPT, Claude, Gemini), przy 1% fałszywych alarmów na jego tekstach ludzi.
wykrytych po humanizerze
te same teksty po przepisaniu narzędziem StealthGPT. Pangram osiąga 98%: na tekstach po humanizerze jesteśmy za nim.
tekstów AI po rosyjsku i polsku
wykrywanych na naszych własnych zbiorach testowych, przy 0,6% (rosyjski) i 1,4% (polski) fałszywych alarmów. Zbiory są małe: spodziewaj się ±5 punktów.
fałszywych alarmów na esejach nie-native
egzaminacyjne eseje TOEFL osób, dla których angielski nie jest ojczysty, to słabe miejsce (na zwykłych i szkolnych tekstach ok. 0,2–0,4%). Do takiej pracy użyj trybu Dokładnego.
Nasza własna ocena, nie niezależny audyt. Szczegóły i ograniczenia: Wyniki i raport techniczny. Szczegóły w Wynikach
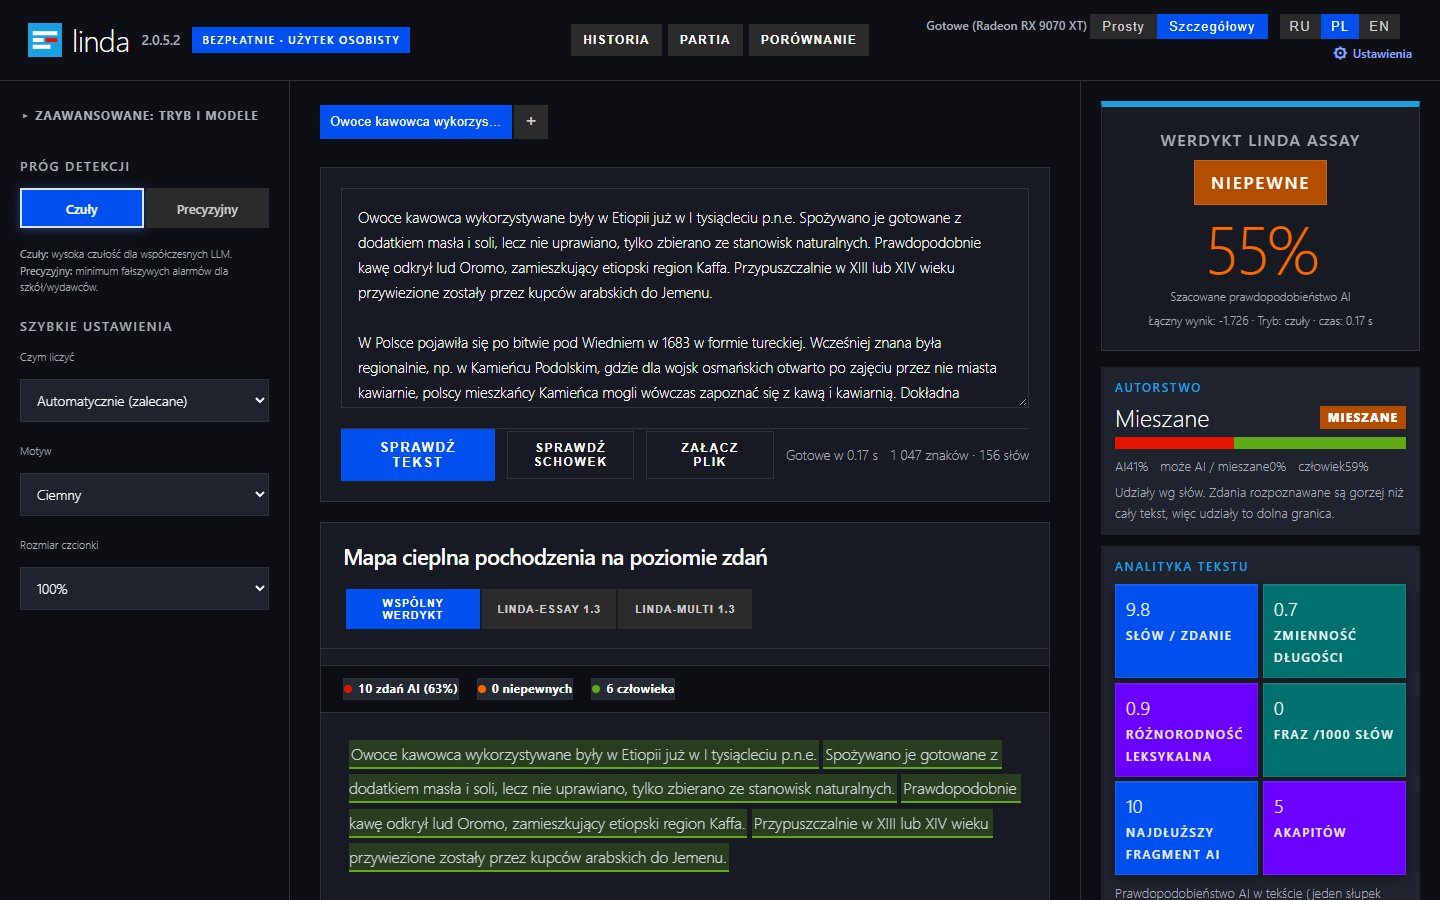
trzy detektory — jeden werdykt
Trzy niezależne modele oceniają tekst osobno, a Ty dostajesz jeden jasny werdykt z podświetlonymi podejrzanymi miejscami.
Wklej tekst lub upuść plik
Wklej tekst lub prześlij TXT, MD, DOCX albo PDF. Pliki: do 20 MB; PDF: do 500 stron. Dłuższy tekst wymaga więcej czasu na analizę.
Otrzymaj werdykt
Człowiek, AI czy wynik niepewny? Zobaczysz procentowy udział AI przy tekstach mieszanych oraz kolorową mapę podejrzanych fragmentów.
Wybierz tryb: więcej wykryć albo mniej pomyłek
Tryb Czuły wyłapuje więcej tekstów AI, ale może pomylić się przy pracy człowieka. Tryb Precyzyjny wskazuje AI tylko wtedy, gdy potwierdzą to dwie niezależne analizy: mniej fałszywych alarmów, ale część tekstów AI może mu umknąć. W szkołach i wydawnictwach zalecamy tryb precyzyjny.
postęp: 1.1 → 1.3.1
W teście HumanizerBench wszystkie programy sprawdzały dokładnie te same zmodyfikowane teksty. Im wyższy odsetek wykryć AI, tym lepiej.
Werdykty konkurentów — według operatorów benchmarku; ich progi są nieznane, więc poziomy fałszywych alarmów są nieporównywalne.
zacznij za darmo, płać tylko za użytek komercyjny
Do zadań osobistych, nauki i hobby program jest bezpłatny na zawsze — bez okrojonych funkcji i limitów czasowych. Płatne warianty są przeznaczone do działalności komercyjnej (freelance, redakcja, sprawdzanie cudzych prac na zlecenie, firmy). Zakup klucza daje oficjalne prawo do użytku komercyjnego i wyłącza przypomnienie o licencji w interfejsie.
Bezpłatny
- Osobisty użytek niekomercyjny: Twoje teksty, nauka, hobby, badania niekomercyjne
- Ta sama aplikacja i modele — bez klucza i limitów
- Działa offline, teksty nigdzie nie trafiają
Personal
- 1 osoba, do 3 urządzeń
- Freelance i mały biznes
- Po jednorazowej aktywacji działa offline
Team
- Do 10 osób, 20 urządzeń
- Użytek komercyjny
- Po jednorazowej aktywacji działa offline
Organization
- Firma, szkoła lub uczelnia, jedna siedziba, 200 urządzeń
- Aktualizacje przez cały rok, w tym nowe modele
- Faktura VAT
Nie masz pewności, co kwalifikuje się jako użytek niekomercyjny? Przeczytaj zasady.
Na stronie płatności wybierz Team.
OEM, white-label, prawa wyłączne, kalibracja na zamówienie
Integracja Linda z Twoją platformą (LMS, antyplagiat, narzędzie wydawnicze lub HR), kalibracja na Twoich tekstach albo zakup praw wyłącznych: napisz na lindapro.support@proton.me — opisz przypadek użycia, wolumen i wdrożenie.
pytania i odpowiedzi
Co oznacza procent w wyniku?
To pewność werdyktu pokazanego obok („AI”, „człowiek” lub „niepewne”), a nie udział tekstu napisanego przez AI: 88% przy „AI” oznacza, że modele są dość pewne, że tekst napisała maszyna. Jaka część tekstu wygląda na napisaną przez AI, pokazano osobno (mapa kolorów, „udział AI” i pasek autorstwa). Wysoki procent to powód, by przyjrzeć się bliżej, a nie dowód; zobacz „Jeśli wynik jest wysoki”. Bardzo krótkie teksty (poniżej ok. 150 słów) dają mniej wiarygodny wynik, a program o tym ostrzega.
Czy moje teksty są gdzieś wysyłane?
Nie. Teksty są analizowane na Twoim komputerze. Aplikacja łączy się z internetem tylko po to, aby pobrać pliki modeli, sprawdzić aktualizacje i — jeśli wpiszesz klucz — zweryfikować go (wysyłane są tylko klucz i losowy identyfikator urządzenia, nic więcej).
Czy program jest dokładny? Czy może przez pomyłkę oskarżyć człowieka?
Żaden detektor nie jest idealny. Na odłożonych tekstach ludzi odsetek fałszywych alarmów to ok. 0–2% dla zwykłych tekstów i 5,5% dla esejów egzaminacyjnych TOEFL w trybie czułym (ok. 1% w trybie dokładnym, pomiar na wersji 1.3). Mocniej dotyczy to osób, dla których angielski nie jest językiem ojczystym. Nigdy nie traktuj wyniku jako jedynej podstawy decyzji o ludziach.
A co z narzędziami AI typu „humanizer”?
Wersja 1.3.1 używa nowych modeli scalonych z trzech wytrenowanych wariantów. W otwartym teście wykrywa 81% przepisanych tekstów (wersja 1.1: 70%, wersja 1.0: 31%). Ponieważ humanizery stale ewoluują, regularnie uaktualniamy modele, a program pobiera je automatycznie.
Jakie języki?
Angielski to główny język, ale rosyjski i polski działają teraz na tych samych modelach. Na naszych zbiorach testowych (po 350 tekstów AI i 350 ludzkich na język) werdykt „AI” wykrywa około 80% (polski) i 78% (rosyjski) tekstów AI przy 0,9% i 0,6% fałszywych alarmów (wersja 1.1: 39% i 57%). Teksty nowszych modeli i przepisane są wykrywane rzadziej (polski przepisany przez Gemini: 48%, rosyjski: 50%). Zbiory są małe, spodziewaj się rozrzutu ±5 punktów. Nie porównywaliśmy rosyjskiego ani polskiego z innymi detektorami, więc nie deklarujemy porównań. Inne języki nie są obsługiwane. Dokładne liczby są w sekcji wyników.
Czy to bezpłatne?
Tak — do osobistego użytku niekomercyjnego: własne teksty, nauka, hobby, badania niekomercyjne. Bez rejestracji, bez klucza, bez limitów. Płatny klucz to tylko zezwolenie na użytek komercyjny (praca zarobkowa, klienci, firmy, szkoły i uczelnie, produkty): ukrywa przypomnienie o licencji; sama aplikacja bez niego działa tak samo. Zobacz cennik.