Распознайте текст, написанный ИИ прямо на вашем компьютере.
Linda определяет, написан ли текст искусственным интеллектом, и подсвечивает подозрительные фрагменты.
12 попыток · до 6 000 знаков · минимум 20 слов, рекомендуется от 300. TXT, MD, DOCX. Онлайн-демо отправляет текст на сервер; настольное приложение работает локально.
Тексты и модели остаются на вашем ПК
Детекция локальная. Модели около 0,3 ГБ для Loupe или 2,9 ГБ для Assay; анализ может работать офлайн. Обновления и активация/периодическая проверка лицензии используют сеть без отправки текстов.
Бесплатно для личного некоммерческого использования. Ключ не нужен — скачайте и проверяйте.
В Microsoft Store обновления выходят в среднем на неделю позже, чем на GitHub. Нужна самая свежая версия сразу? Берите установщик с GitHub.
на CPU
81% из 1 675 ИИ-текстов, переписанных 16 «гуманизаторами», всё равно распознаются как ИИ (открытый набор HumanizerBench, в обучении не участвовал). Подробности в разделе Результаты
Linda Assay и Linda Loupe
Выберите то, что подходит вашему компьютеру. Можно поставить любую или обе, а позже изменить это в настройках.
Текущие версии: приложение 2.0.7.0 · пакет моделей 1.3.4.1. Assay FP32 stable / Loupe CPU; короткие ИИ-вставки могут пропускаться.
Linda Loupe
Лёгкая и быстрая. Работает на любом компьютере, даже на старом ноутбуке без игровой видеокарты.
- Проверка занимает секунды
- Небольшая загрузка (около 0,3 ГБ)
- Чуть менее точная
Linda Assay
Самая точная версия. Лучше всего с современной видеокартой.
- Максимальная точность
- Загрузка около 3 ГБ
- На слабом компьютере длинный текст может идти минуты
Не уверены?
Начните с Linda Loupe: она запускается везде. Захотите максимальной точности — добавите Linda Assay в настройках одним щелчком.
что находит Linda Assay и как часто ошибается
обычных ИИ-текстов найдено
на открытом бенчмарке Chicago Booth (тексты GPT, Claude, Gemini), при 1% ложных тревог на его человеческих текстах.
найдено после гуманизатора
те же тексты после переписывания инструментом StealthGPT. Pangram достигает 98%: на «очеловеченных» текстах мы ему уступаем.
ИИ-текстов на русском и польском
находится на наших собственных тестовых наборах, при 0,6% (русский) и 1,4% (польский) ложных тревог. Наборы небольшие: ориентируйтесь на ±5 пунктов.
ложных тревог на эссе не носителей
экзаменационные эссе TOEFL от тех, для кого английский не родной, — слабое место (на обычных и школьных текстах около 0,2–0,4%). Для такой работы включайте «Точный» режим.
Наша собственная оценка, не независимый аудит. Подробности и ограничения — в «Результатах» и техническом отчёте. Подробности в разделе Результаты
три модели — один вердикт
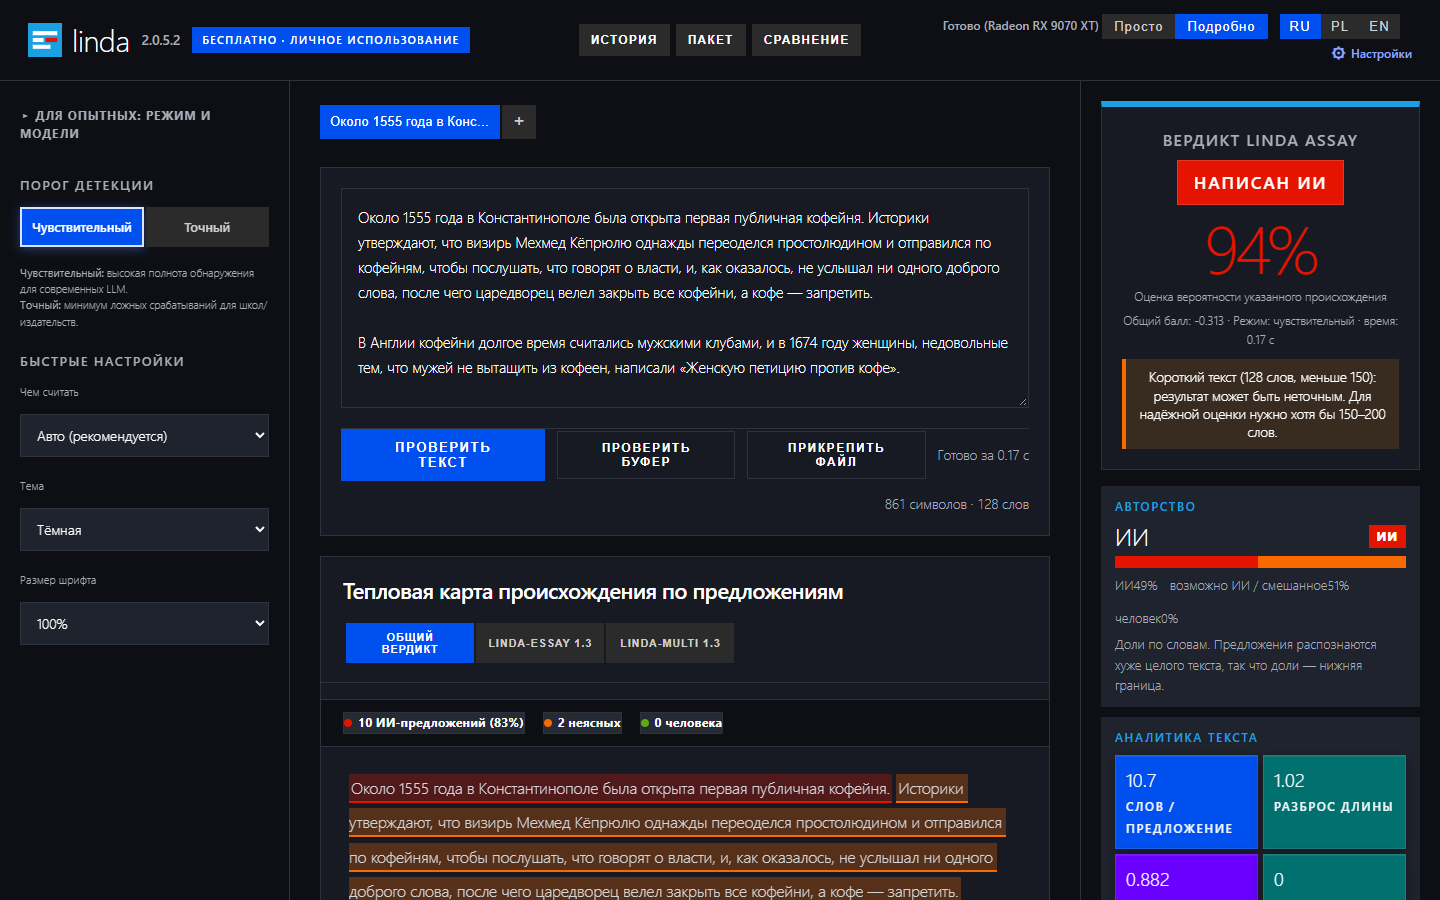
Три независимые модели оценивают текст отдельно, а вы получаете один понятный вердикт с подсвеченными подозрительными местами.
Вставьте текст или файл
Вставьте текст или загрузите TXT, MD, DOCX либо PDF. Файлы — до 20 МБ, PDF — до 500 страниц. Чем длиннее текст, тем дольше проверка.
Получите вердикт
ИИ, человек или смешанный текст: программа покажет долю текста с признаками ИИ и подсветит фрагменты цветом.
Выберите режим: больше находок или меньше ошибок
Чувствительный находит больше ИИ-текста, но чаще ошибается на человеческом. Точный говорит «ИИ», только если согласны две независимые модели: ложных срабатываний меньше, но часть ИИ-текста пропускается. Для школ и издательств, где ложное обвинение обходится дороже всего, лучше Точный.
прогресс: 1.1 → 1.3.1
HumanizerBench дал всем детекторам одни и те же переписанные тексты. Чем выше доля распознанного как ИИ, тем лучше.
Вердикты конкурентов — по данным операторов бенчмарка; их пороги неизвестны, поэтому уровни ложных срабатываний несопоставимы.
начните бесплатно, платите только за коммерческое использование
Для личных задач, учёбы и хобби программа бесплатна навсегда и без ограничений. Ключ нужен для коммерческой работы: фриланс, редактура, проверка работ на заказ, компании. Он даёт официальное право на коммерческое использование и убирает напоминание о лицензии.
Бесплатно
- Личное некоммерческое использование: ваши тексты, учёба, хобби, некоммерческие исследования
- То же приложение и модели — без ключа и ограничений
- Работает без интернета, тексты никуда не уходят
Personal
- 1 человек, до 3 устройств
- Фриланс и малый бизнес
- После разовой активации работает без интернета
Team
- До 10 человек, 20 устройств
- Коммерческое использование
- После разовой активации работает без интернета
Organization
- Компания, школа или вуз, одна площадка, 200 устройств
- Обновления весь год, включая новые модели
- Счёт с НДС
Не уверены, что считается некоммерческим? Читать правила.
На странице оплаты выберите Team.
OEM, white-label, эксклюзивные права, калибровка под вас
Если вам нужна интеграция Linda в LMS, систему антиплагиата или HR-сервис, дообучение на ваших текстах или эксклюзивные права — напишите на lindapro.support@proton.me. Расскажите о задаче, объёмах и вашей инфраструктуре.
вопросы и ответы
Что означает процент в результате?
Это уверенность в вердикте, который показан рядом («ИИ», «человек» или «не уверена»), а не доля текста, написанная ИИ: 88% рядом с «ИИ» значит, что модели довольно уверены, что текст написала машина. Какая часть текста выглядит написанной ИИ, показано отдельно (цветная карта, «доля ИИ» и полоса авторства). Высокий процент — повод присмотреться, а не доказательство; см. «Если процент высокий». Очень короткие тексты (меньше примерно 150 слов) дают менее надёжный результат, программа об этом предупреждает.
Мои тексты куда-то отправляются?
Нет, тексты проверяются прямо на вашем компьютере. Программа выходит в интернет только чтобы скачать модели, проверить обновления или активировать платный ключ (передаются только сам ключ и случайный ID устройства).
Насколько точен детектор? Может ли он по ошибке обвинить человека?
Ни один детектор не безошибочен. На отложенных человеческих текстах доля ложных срабатываний около 0–2% для обычных текстов и 5,5% для экзаменационных эссе TOEFL в чувствительном режиме (около 1% в точном режиме, замер на версии 1.3). Сильнее страдают авторы, для которых английский не родной. Никогда не используйте результат как единственное основание для решений о людях.
А как же ИИ-«гуманизаторы»?
Версия 1.3.1 использует новые модели, объединённые из трёх обученных вариантов. На открытом тесте гуманизаторов она отмечает 81% переписанных текстов (версия 1.1: 70%, версия 1.0: 31%). Гуманизаторы меняются каждый месяц, поэтому модели регулярно обновляются, а приложение скачивает обновления.
Какие языки?
Английский — основной язык, но русский и польский теперь работают на тех же моделях. На наших отложенных тестовых наборах (по 350 ИИ- и 350 человеческих текстов на язык) вердикт «ИИ» ловит около 80% (польский) и 78% (русский) ИИ-текстов при 0,9% и 0,6% ложных срабатываний (версия 1.1: 39% и 57%). Тексты новых моделей и переписанные тексты ловятся реже (польский, переписанный Gemini: 48%, русский: 50%). Наборы небольшие, ориентируйтесь на разброс ±5 пунктов. С другими детекторами на русском и польском мы не сравнивались, поэтому сравнений не заявляем. Другие языки не поддерживаются. Точные цифры — в разделе результатов.
Это бесплатно?
Да — для личного некоммерческого использования: ваши тексты, учёба, хобби, некоммерческие исследования. Без регистрации, без ключа, без ограничений. Платный ключ — это только разрешение на коммерческое использование (оплачиваемая работа, клиенты, компании, школы и вузы, продукты): он убирает напоминание о лицензии; само приложение без него работает так же. См. цены.